タッチレス自動化とHITLにおけるディープラーニング/大規模言語モデルの使い分けと、ビジネストランスフォーメーションにおけるAIエージェントへの移行
概要
本稿は、クライアントおよび社内メンバーとの議論を通じて得られた問題意識を背景に執筆したものです。これらの議論では、多くのユースケースにおいて大規模言語モデル(LLM)が優先的に検討される一方で、従来型のディープラーニング(DL)との適切な使い分けが十分に整理されていない状況が見受けられました。
LLMは強力で導入しやすい技術である一方、その特性と限界を踏まえると、AIアーキテクチャ全体の中でどの領域に適用するのが適切かを見極めることが重要になってきます。
本稿では、保険引受業務や保険金支払い業務のように、ドキュメントから構造化データを抽出することが自動化の中核となる業務プロセスを対象に、その実現アプローチを整理していきます。これは、インテリジェント・ドキュメント処理(IDP)の中でも特に重要な領域です。
また、タッチレス処理およびHuman-in-the-Loop(HITL)をビジネス要件として捉え、それらがAIモデルの選定や、より広範なAIアーキテクチャ設計にどのような影響を与えるのかについて考察していきます。
さらに、AIツールがエージェント型AIアプローチと広義に結び付けて理解されるケースは少なくありませんが、その関係性が明確に整理されているとは必ずしも言えません。
IDPは保険引受・保険金支払い業務の自動化の中核である
まず、保険業務において、ドキュメントデータ抽出の自動化がなぜ重要なのかを整理していきます。本稿における「自動化」とは、完全なタッチレス処理に限らず、人による判断を補完・強化する形も含めた広い概念を指します。
2025年に発行された「ソラーズAIレポート」では、複数の保険会社への詳細なインタビューを通じて、IDPが保険業界におけるAI活用の中でも特に重要なトレンドの一つであることが示されています。
一方で、現時点では保険金支払い業務の方が、引受業務と比較して自動化の進展が先行している状況です。
こうした動向を踏まえ、Sollersでは引受プロセス全体のエンドツーエンド自動化に向けたビジョンを整理しています。
ビジネス視点
タッチレス自動化にはAI認識結果の正確性に対する統制が必要である
タッチレス自動化はすべての業務プロセスで実現できるわけではありませんが、最終的な目標としては、人手を介さずに業務が完結する状態が想定されます。例えば、保険金請求の受付から支払いまでを一気通貫で自動化するようなケースがこれにあたります。
一方で、ビジネス判断に直接影響する重要なデータ項目については、AIの認識結果に対して一定の統制を行うことが不可欠となります。
誤り率を統計的に許容し、誤った保険金支払いをコストとして織り込むという考え方も、理論的には可能です。
HITLを有効に機能させるにはユーザーへの適切なガイダンスが必要である
HITLの設計が不十分な場合、ユーザーはAIが抽出した多数の項目を、長いPDFを頼りに手作業で確認することになります。どこを見ればよいのかという指示もないままでは、探索作業に時間がかかり、注意力も分散し、結果として確認精度そのものが低下します。
検証すべきデータ項目を明確に絞り込むことが重要である
ユーザーにはまず、案件全体の状況を俯瞰できる形で提示し、どの判断・確認が必要なのかを明確に理解できるようにすることが重要です。不要な情報をすべて確認させるような設計は避けるべきです。
ソースデータへのアクセス性を高めることが重要である
AIが抽出した値をユーザーが確認する際には、作業ができるだけ短時間で直感的に完了することが求められます。該当するドキュメント箇所を直接提示し、抽出結果をハイライトすることで、ユーザーは探すことなく即座に確認できる状態にすることが望ましいです。
AIモデルの定義
主要なクラウドプロバイダーは、インテリジェント・ドキュメント処理(IDP)で活用される2つの主要なAIモデル、すなわちディープラーニング(DL)モデルと大規模言語モデル(LLM)の双方を提供しています。
ディープラーニング(DL)モデル
従来型のディープラーニングモデルは、画像分類、音声認識、ドキュメントデータ抽出といった、明確に定義された特定タスクに特化して学習されるニューラルネットワークです。
大規模言語モデル(LLM)
大規模言語モデル(LLM)は、単一の非常に大規模なディープラーニングモデルであり、一般的にはトランスフォーマーアーキテクチャに基づいて構築されます。多数のニューラルネットワーク層と数十億規模のパラメータで構成されています。
こうしたモデルは膨大なテキストデータを用いて学習され、言語の構造やパターンを汎用的に捉えることを目的としています。
従来型のDLモデルが単一タスクに最適化されるのに対し、LLMは単一のモデルで、生成、理解、要約、推論といった多様なタスクに対応できる点が特徴です。
DLモデルとLLMの比較
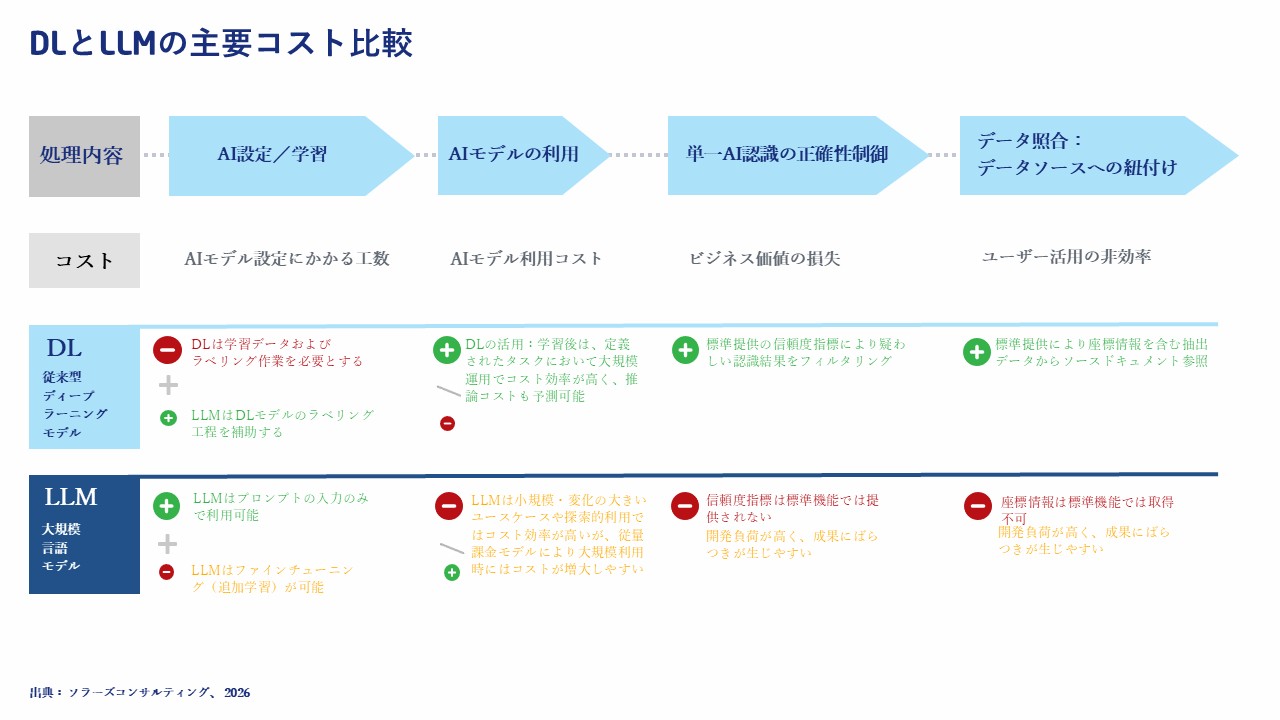
LLMは導入・設定のハードルが低い
LLMは、学習用データセットを用意することなく、プロンプトのみで設定・活用できる点が大きな特徴です。扱うデータ構造が複雑な場合にはプロンプト自体も複雑になりますが、それでも従来型DLモデルの学習と比較すると、導入の負担は大幅に低くなります。
一方、DLモデルでは通常、数百件規模のドキュメントと詳細なラベリングが必要となります。例えばキーワードの特定や適切なラベル付与などが求められ、一般的には1つのラベルあたり50〜200件程度のドキュメントが必要とされます。
もっとも、近年のIDPソリューションでは、DLモデルに必要なラベリング作業そのものにLLMを活用し、ユーザーの生産性を高めるアプローチも広がっています。
DLモデルの方がコスト効率に優れる場合がある
大量処理かつタスクが明確に定義されたドキュメント抽出においては、タスク特化型のDLモデルの方が、LLMに比べて推論あたりの計算コストが低くなる傾向があります。
そのため、大規模に展開する場合には、DLモデルの方がコスト効率に優れるケースが多くなります。
DLモデルは認識精度の統制が容易である
成熟したDLモデルでは、抽出された各データ項目やラベルに対して、信頼度(Confidence Level, CL)が標準機能として提供されることが一般的です。
これにより、不確実な認識結果を統計的に判定し、人手による処理へ振り分けるといった制御を容易に実現できます。
これに対してLLMは、標準機能として信頼度を提供しません。プロンプトを通じて信頼度の推定値を出力させることは可能ですが、汎用モデルであるという特性上、それらの値は必ずしも信頼性の高い指標とはなりません。
モデルはソース参照情報を提供できる
ソーストレーサビリティの観点でも同様の傾向が見られます。成熟したDLモデルでは、抽出データの位置情報(座標)を含めたドキュメント参照情報が標準で提供されることが多いです。
これにより、ユーザーは迅速かつ正確に検証を行うことができます。 一方でLLM自体には、このような参照情報を提供する機能はありません。近似的に再現するための手法はいくつか存在しますが、必ずしも安定した結果が得られるとは限らず、追加の実装や運用コストが必要となる場合が多いです。
IDPの実装
コアとなるデータ抽出におけるDLとLLMの選択
PoC(概念実証)の初期段階においては、LLMが最も手軽な選択肢となることが多いです。導入が容易であり、短期間で初期成果を可視化できるため、有望な結果を得やすいという特徴があります。
一方で、これまで見てきたように、対象プロセスを包括的な視点から捉えると、単純な技術選定では済まない複雑さが見えてきます。
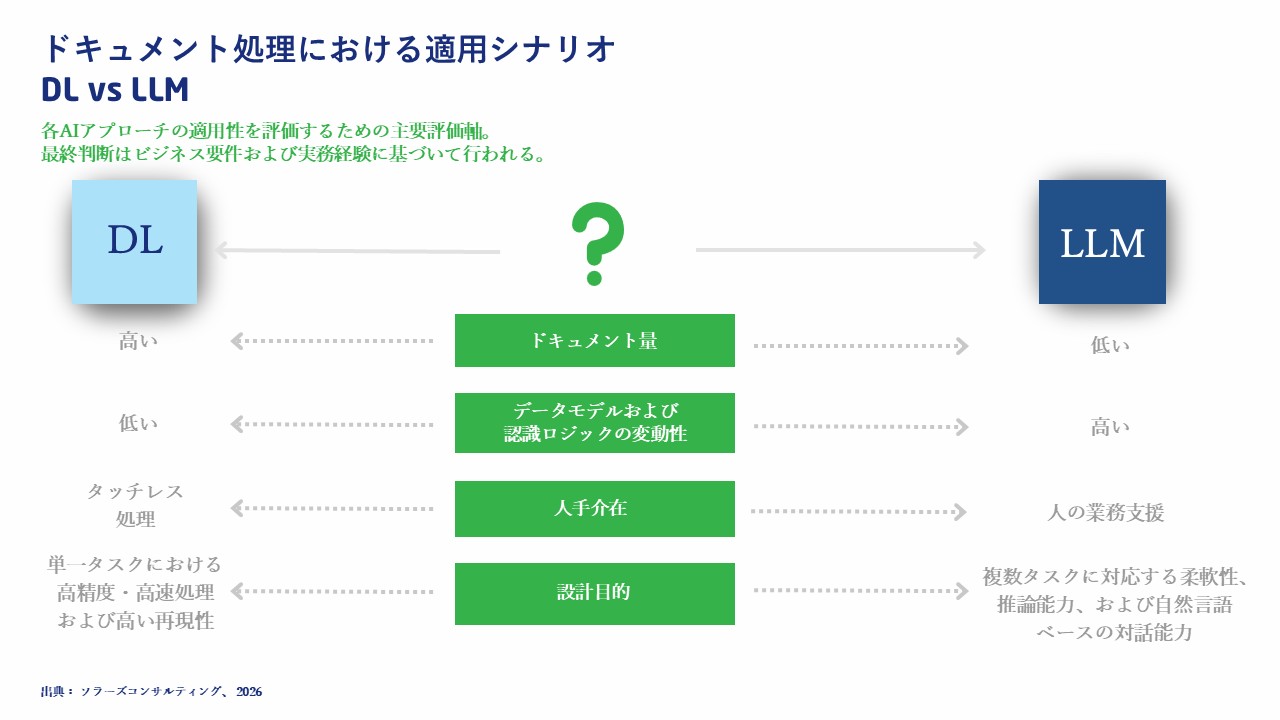
下記の図では、どのような条件下でDLとLLMのどちらが適しているかを判断するための代表的な要素を示しています。最終的な意思決定は、個別技術ではなく、全体的なビジネスケースに基づいて行う必要があります。
ただし初期段階では、その判断に必要な知見やデータが十分に揃っていないことも多いです。この理解は、試行・検証・実装といった実践を通じて徐々に蓄積され、結果として失敗からの学習も重要な要素となります。
データ抽出はIDP全体の一部に過ぎない
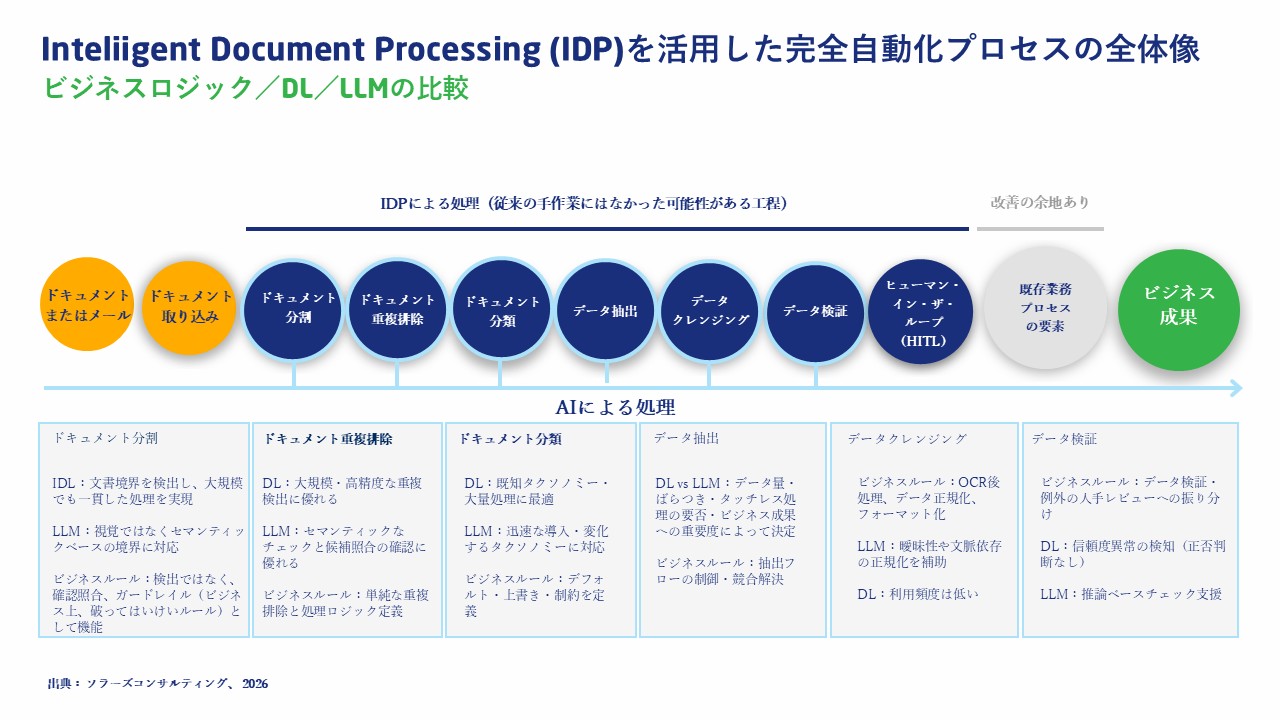
ドキュメントからのデータ抽出は、IDP全体の中の一工程に過ぎません。PoCではこの部分に焦点が当たりやすいですが、実際のエンドツーエンドプロセスでは、ドキュメント分割、重複排除、分類、データ抽出、クレンジング、検証といった複数の工程が存在し、これらもAIによる自動化の対象となります。
全体像を正しく捉えるためには、DLモデルやLLMに加えて、ビジネスルール(より広義には業務ロジック)も含めて考える必要があります。これらはIDPにおいて不可欠な役割を担います。
下記の図では、IDPライフサイクル全体を通じて、ビジネスルール、DL、LLMがどのように適用されるかの代表的なパターンを示しています。
AIエージェント
概念的にはAIエージェントは追加レイヤーとして位置付けられる
ここまで読み進めると、エージェント型AIアプローチが、これまで述べてきたIDPやAIモデル選定の考え方を変えるのかという疑問が生じるかもしれません。その答えは「YesでもありNoでもある」と言えます。
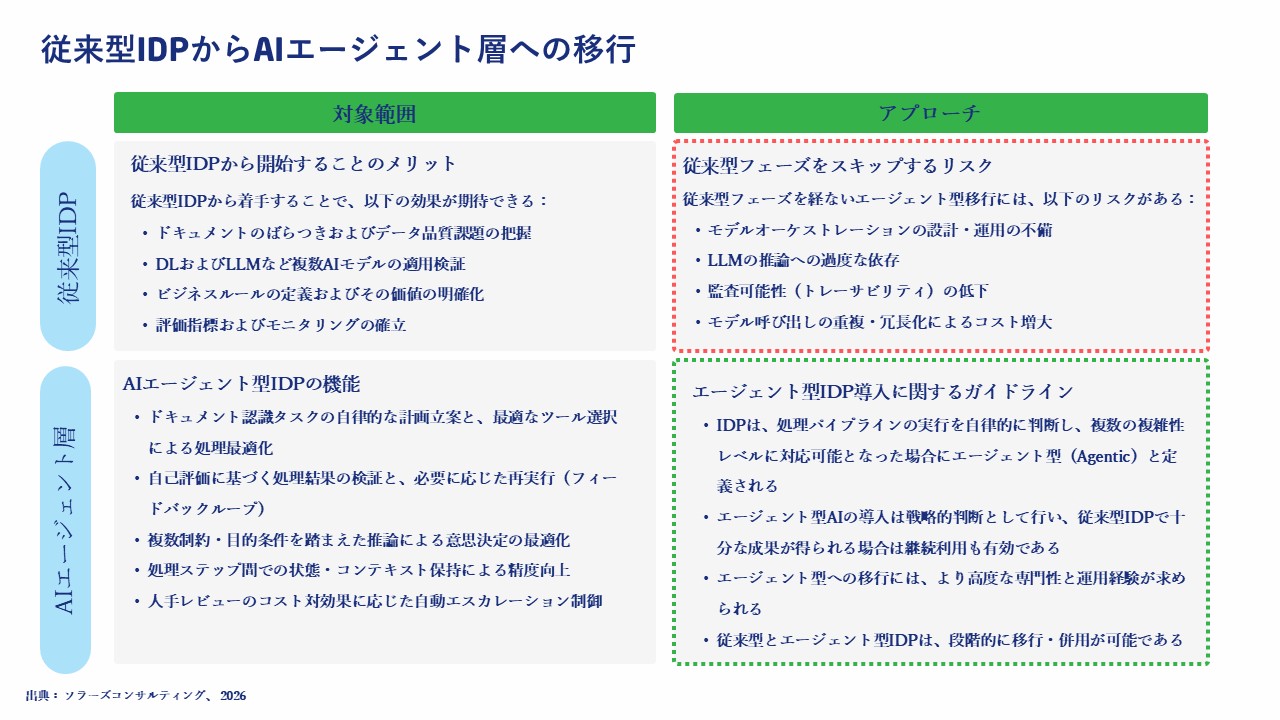
IDPは、従来型IDPレイヤーとエージェント型IDPレイヤーの2層構造として捉えることができます。エージェント型レイヤーは確かにシステム設計の複雑性を高めますが、従来型IDPの理解や実装が不要になるわけではありません。
むしろエージェント型アプローチは、既存のIDPパイプラインをより柔軟かつ効率的にオーケストレーションし、再利用・管理するための仕組みと位置付けるのが適切です。
このため、エージェント型アプローチは段階的に導入することが望ましいです。まずは従来型IDPを実装し、モデルの学習やファインチューニング、安定運用に関する知見をチーム内で蓄積した上で、段階的にエージェント機能を拡張していくべきです。
エージェント型アプローチは複雑なシナリオに限定して適用する
IDPがエージェント型となるのは、固定的なパイプラインに従うのではなく、目的やコンテキスト、中間結果に応じてドキュメント処理の方法を動的に判断できるようになった場合です。
エージェント型アプローチの導入は、全体の費用対効果を最適化するという明確な目的に基づくべきです。多くのケースでは、従来型IDPで十分な成果が得られる場合も少なくありません。
IDPの価値の大部分は、高品質なモデル、適切に設計されたビジネスルール、有効な指標によって生み出されます。エージェントはこれらを補完・強化するものであり、置き換えるものではありません。
エージェント型アプローチは、以下のような条件に該当する場合に限定して検討すべきです。
ビジネストランスフォーメーション
AIを超えて ― エンドツーエンドプロセスとターゲットアーキテクチャ
ここまでIDP、AIモデル、AIエージェントについて述べてきましたが、実際の導入成功には単なる技術選定以上の要素が求められます。
保険引受や保険金支払いといったコア業務をどのようにエンドツーエンドで自動化するかを明確にし、それを支えるターゲットアーキテクチャを設計する必要があります。
知識不足の罠
適切なツールは重要ですが、AIによる自動化において正しいアーキテクチャを選択するためには、実践に裏付けられた知見が不可欠です。
アドバイザーの役割 ― 導入の加速と内製化の強化
経験豊富な専門家やコンサルティング会社を活用することで、実績に基づく知見やベストプラクティスを取り込み、導入を加速させることができます。
一方で、この過程を通じて社内チームのスキル向上を図ることも同様に重要です。最終的には、保険会社自身が自律的にアーキテクチャや変革の意思決定を行える体制を構築する必要があります。
今後のアプローチ ― 段階的かつ進化的な導入と学習
まずは、目指すべきターゲットアーキテクチャとその構成要素について、大枠のビジョンを描くことが重要です。導入初期はクラウドのAIサービスなど比較的シンプルなツールから着手し、実践を通じて知見を蓄積します。
その上で、IDP基盤やエージェント型プラットフォームといった高度な要素については、十分な経験を踏まえながら段階的に意思決定を行うべきです。
長期的なビジョンを前提としつつ、継続的な学習と段階的なアーキテクチャ構築を組み合わせたアプローチを採用することが望ましいです。